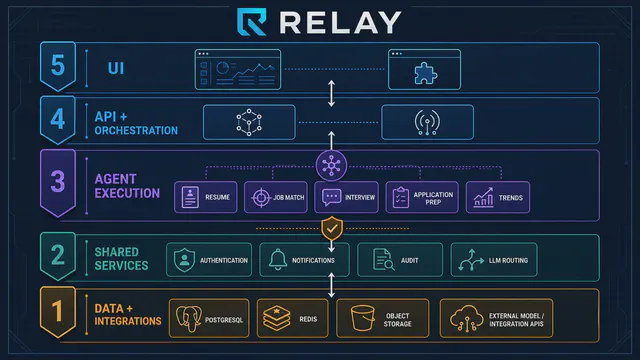

架构图是一张承诺清单;源码审计要问的是,其中哪些箭头已经有了重量。
这篇文章的旧版把 Relay 写成一个公开的开源方案,还说它的 Agent 层尚未开工。到 2026 年 7 月 31 日,这两个判断都不再成立:旧文引用的公开 GitHub 地址返回 404,而我能够核对的是一份私有本地检出。
因此,本文是一份私有本地实现审计,事实固定在本地提交 22586e17ccd43cfaff0512511e71a100c5341608。读者不应据此推断仓库或该提交可以公开下载。
这条边界看似扫兴,却很重要:我可以说明本地代码里有什么,不能把私有证据包装成任何人都能复现的公开结论。
四种状态,四种证据
下文对关键结论使用四种状态:
- 已实现:审计提交中存在对应的生产路径代码。
- 已测试:存在聚焦测试,并在本次审计中实际运行。
- 设计中:它是文档意图或已经识别的要求,不是完成承诺。
- 示意:用于解释工程方法,不代表 Relay 的精确代码或性能。
“文档里写了”不属于第五种状态。文档记录愿望,执行路径才暴露系统真正承担的责任。
当前实现快照
本地检出已经远远超过一份方案:
| 区域 | 审计结果 | 状态 |
|---|---|---|
| 协调器 | Ask Vantage 路由器与 ReAct dock 入口存在 | 已实现 |
| 领域 Agent | 简历、职位匹配、面试、投递准备、趋势五个模块存在 | 已实现 |
| Harness | 成本、Guard、上下文压缩、checkpointer、权限、审计和事件能力存在 | 已实现 |
| Agent API | 流式响应、简历、投递、模拟面试和简历构建等 FastAPI 路径存在 | 已实现 |
| TypeScript API | 有 16 个非测试 route 模块,其中 14 个直接挂载,2 个作为嵌套路由使用 | 已实现 |
| 事件系统 | Redis 事件总线、消费者与处理器存在 | 已实现 |
| 浏览器链路 | Playwright MCP 客户端和需审批的浏览器工具存在 | 已实现、已测试 |
| 数据迁移 | 迁移编号从 001 到 022,SQL 中共有 21 条 CREATE TABLE | 已实现 |
| 公开可用性 | 旧文引用的 GitHub 地址当前不可访问 | 非公开 |
本次审计运行了路由器、浏览器工具和成本追踪器的聚焦测试,共 47 项通过。这只能证明这些路径在审计环境中的表现,不能替代生产端到端测试。
状态:在审计提交上已测试。
现在值得讨论的已经不是“这个设计多么宏大”,而是设计落地以后,系统把失败边界放在了哪里。
一个协调器,五个领域 Agent
Relay 将对话路由与五个领域模块分开:
ResumeAgent解析、分析、优化和定制简历。JobMatchAgent接收并匹配职位。InterviewAgent组织面试准备和评估流程。AppPrepAgent准备投递材料和浏览器动作。TrendAgent提取并总结市场信号。
状态:已实现。
这并不意味着多 Agent 天生更快或更聪明。一个边界是否值得拆开,通常取决于四件事:
- 触发方式是否不同:对话、事件、定时任务或用户显式动作;
- 模型与时延要求是否不同;
- 数据归属是否不同;
- Prompt 与评测集是否以不同节奏演化。
旧文声称协调成本会按 (O(N^2)) 增长,但这份代码没有提供支持该复杂度结论的基准。协调代价取决于拓扑、共享状态、工具契约与跨 Agent 交接次数,而不是 Agent 数量这一项。
协调器当前仍用 langgraph.prebuilt.create_react_agent 构建 dock graph。
状态:已实现,但存在迁移债。
LangChain 当前的官方 Agent 文档
把 langchain.agents.create_agent 作为高层入口,v1 迁移指南
也说明了从 create_react_agent 迁移的方向。Relay 不需要为接口名称立刻重写稳定路径,但新中间件与运行时能力不应继续加深旧依赖。
分类器比旧稿描述得更小
源码中的 REGEX_ACCEPT_THRESHOLD 是 0.85,不是旧文声称的 0.95。正则命中且置信度达到阈值时,classify_intent() 可以接受结果。
状态:分类器模块中已实现。
但旧版所谓 Layer 2 LLM 分类器已经删除:低于阈值或没有匹配的输入会落到 other。生产 dock 也在 2026 年 7 月 8 日移除了旧的通用正则快路径,因为它产生的事件词汇与 AG-UI 消费者不兼容。现在一般请求进入 ReAct 循环;7 月 13 日新增的确定性快路径只服务于“粘贴职位描述后定制简历”这一狭窄场景。
状态:Layer 2 未实现;通用 dock 快路径已移除,仅保留职位描述定制窄路径。
这正是架构文章容易腐烂的方式:一个模块仍在目录里,不代表它仍位于真实请求路径上。
HITL 是事务边界
Relay 最值得保留的原则是:会改变外部状态的浏览器动作需要用户批准。浏览器快照被视为只读通知,而导航、点击和表单填写由审批装饰器包裹。
状态:已实现。
LangGraph 的 interrupt() 与 Command(resume=...) 很适合这种流程,但恢复语义经常被讲错。恢复并不是从某一行 Python 代码后继续,好像运行栈被原样冻结。根据官方 interrupt 指南
,恢复时节点会从开头重新执行,传入的 resume 值成为 interrupt() 的返回值。
def approval_node(state):
    decision = interrupt({
        "action": "fill_form",
        "fields": state["proposed_fields"],
    })

    if decision["type"] != "approve":
        return {"status": "cancelled"}

    # 不可逆动作放在批准之后。
    return perform_idempotent_fill(
        key=state["operation_id"],
        fields=decision.get("fields", state["proposed_fields"]),
    )
所以,interrupt() 之前的任何操作都可能再次发生:数据库插入需要幂等键或 upsert,消息需要去重,外部调用最好放到批准后的独立节点。LangGraph 持久化指南
也说明了另一半前提:可靠的人类审核需要 checkpointer 和稳定的 thread ID。
Relay 状态:持久化 checkpointer 支持已实现;每个副作用仍需逐项做幂等审计。
HITL 不是一个装饰性的确认框,而是由四部分组成的事务边界:
- 完整展示待执行动作;
- 允许用户修改决策载荷;
- 用正确的用户和 thread 标识持久化状态;
- 批准后走幂等执行路径。
缺少任意一项,“人在回路”都可能只剩下戏剧效果。
Harness 才是可靠性真正居住的地方
Relay 在 graph runtime 外包了一层 Harness,负责模型选择、成本核算、预算 Guard、上下文压缩、权限、持久化、审计和事件发送。
状态:已实现。
这是我最信任的 Agent 工程方向:Prompt 描述理想行为,Harness 负责在行为漂移时限制损害。更完整的讨论可参阅站内文章《Agent 工程:真正决定成败的是那 98% 的 Harness》 和《上下文工程:新的基础设施》 。
成本可观测,不等于成本会自动正确
当前代码通过上下文本地计数器记录模型用量,并在模型调用前后执行预算检查。
状态:已实现。
旧稿把精确模型价格、0.50 美元 session 上限与自动分层降级写成了不会变化的产品事实。模型名、供应商价格和配置都可能比文章更新得更快。真正稳定的原则只有几条:
- 记录供应商响应中的真实模型标识与 token 用量;
- 把成本和时延挂到同一条请求 trace;
- 在代码中执行预算,而不是靠 system prompt 劝告;
- 测试预算耗尽时系统如何失败。
价格表也需要明确的更新责任人。精确到小数点后四位,无法弥补价格已经过期。
审计写入目前仍是 best-effort
Relay 的审计 context manager 使用 asyncio.create_task() 调度数据库写入,并保留待完成任务的强引用,避免了 Python 文档提到的一类弱引用风险。
状态:作为 best-effort 遥测已实现。
但“已调度”不等于“已持久化”。进程崩溃或事件循环突然停止,仍可能丢失审计记录。Python task 文档 建议保留任务引用,却不会把后台任务变成可靠队列。
如果某条审计记录具有法律、财务或运维上的强制性,就应使用事务 outbox、持久队列,或在关键路径上等待写入完成。
状态:审计可靠投递属于设计要求,不是已经实现的保证。
事件消费者同理。create_task() 能把工作放到后台,交付语义仍来自确认、重试、去重与持久化 offset。
反虚构 Guard:有限检测器,不是真相机器
Relay 的简历 Guard 会把生成内容中的部分命名实体与定量实体同原始简历比较,覆盖公司、职位、学校、学位、项目名、百分比、金额、年份和较大的独立数字,并给变更记录标记“安全”“需审核”或“不受支持”。
状态:已实现。
这是有价值的运行时兜底,却不能证明简历必然真实。
它可能发现原文没有的“吞吐提升 40%”,却可能漏掉“主导迁移战略”这类没有数字的无依据表述,也可能漏掉重新包装的因果关系、误导性同义词或不在启发式范围内的小数字。
更诚实的能力契约是:
- Guard 降低一组定义明确的无依据实体风险;
- 假阴性仍然存在;
- 生成结论仍需人工审核;
- UI 应为拦截项和模糊项保留来源证据。
状态:有限检测器已实现;完整语义 grounding 仍是设计目标。
“绝不虚构”不是可辩护的承诺。“展示证据,并拦截已知的无依据模式”才是。
浏览器投递是一条安全边界
Relay 可以通过 Playwright MCP 连接用户现有浏览器,请求页面快照,并在批准后执行导航、点击和字段填写。实现会在调用 MCP 前移除类似凭证的字段名,包括密码、PIN、SSN 与信用卡字段。
状态:MCP 链路、写操作 HITL 与有限敏感字段 denylist 已实现。
旧稿说用户自己的浏览器能让辅助行为与手工操作“无法区分”,并能绕过封号与 CAPTCHA。这些说法既没有证据,也会诱导危险实现。平台可以从行为节奏、DOM 交互、扩展信号或服务端控制识别自动化;已有登录态也不等于用户获准自动化任何网站。
生产级浏览器 Agent 至少需要以下控制:
| 控制 | 必要姿态 | 审计状态 |
|---|---|---|
| 域名白名单 | 只访问明确批准的 ATS 与招聘域名 | 设计缺口 |
| 服务条款检查 | 不自动化目标服务禁止的流程 | 设计缺口 |
| 间接提示注入防护 | 页面文字只是不可信数据,不能成为指令来源 | 设计缺口 |
| 敏感字段策略 | 按政策阻止凭证、受监管信息和自我识别字段 | 部分实现 |
| 写操作审批 | 精确预览导航、填写和点击目标及其值 | 已实现 |
| 最终提交边界 | 用户亲自提交,或逐次明确批准 | 策略已定义;需逐路径核对 |
| CAPTCHA | 停止并把控制权交还用户,绝不规避 | 必需策略 |
| 行为限速 | 限制重试、导航频率与重复投递 | 设计缺口 |
| 审计轨迹 | 记录操作者、域名、建议值、决策和结果 | 部分实现 |
OWASP 提示注入指南 特别指出,网站和文件等外部来源可能包含间接提示注入。ATS 页面可以藏入诱导 Agent 改道、泄露数据或调用其他工具的文字。Accessibility snapshot 让模型更容易读页面,却不会让页面内容变得可信。
最安全的心智模型是:浏览器是一件上膛的工具,页面则是一个不可信的调用者。
数据与事件:已经存在什么,还缺什么
审计到的迁移目录从 001 到 022,较新的编号同时提供 forward 与 rollback 文件;所有迁移 SQL 合计有 21 条 CREATE TABLE。这取代了旧稿“17 张表”的过时说法。
状态:迁移 SQL 中已实现。
Schema 包含用户、文件、简历版本、职位、投递草稿、对话、记忆、面试、Agent 配置与任务、简历建议、趋势快照和持久化流事件等数据。
Relay 也有 Redis 事件总线和用于跨 Agent 反应的消费者。
状态:已实现。
但源码不支持“事件必然送达”的承诺。要让简历更新在崩溃后仍可靠触发下游匹配,至少还需要:
- 生产者侧事务 outbox,或具有相同原子性的机制;
- 消费确认;
- 有界重试与死信路径;
- 以 event ID 为键的幂等处理;
- replay 与 lag 的可观测性。
状态:可靠性加固仍处于设计阶段。
一个系统不会因为用了 Redis 就自动解耦。只有当失败归属被写清楚时,解耦才真正发生。
这次审计删除了哪些结论
旧稿中有一些看似精确、实则没有证据的数字:
- 70/25/5 的字段覆盖比例;
- 每次投递 0.003 美元的 LLM 成本;
- 98% 的理论毛利;
- 一个数量级的时延提升;
- “可多匹配 23 个岗位”的建议效果;
- 未提供基准却声称更优的加权匹配质量。
这些结论已经删除。它们可以成为实验假设,不能冒充实现事实。
一份诚实的测量应公开:
- 数据集与采样窗口;
- 任务成功的定义;
- 人工审核协议;
- p50、p95 与错误率;
- 模型及供应商版本;
- 包含重试在内的完整成本分布;
- 基线与置信区间。
状态:示意性评测方案。
如果没有这层证据包络,一个百分比不过是穿着实验服的排版。
2026 年审查 Agent 架构的八个问题
现在审查一个 Agent 系统,我会按顺序问:
- 系统能执行哪些不可逆动作?
- 持久化审批边界在哪里?
- 重试或恢复后,哪些代码会运行两次?
- 哪些模型输出会同来源证据比较?
- 哪些外部内容可能发出间接指令?
- 进程死亡时,哪些事件或审计记录会丢失?
- 哪些结论已经测量,哪些仍只是设计?
- 哪些框架 API 是当前推荐,哪些只是暂时容忍的迁移债?
如果你也在设计类似系统,站内的《如何信任一个无人值守的 AI Agent》 讨论了运维信任边界;《LangGraph 架构深度解析》 则梳理了底层 graph 原语。
结语
Relay 已经从架构方案跨进了真实实现:协调器、五个领域 Agent、Harness、路由、事件、迁移历史和 MCP 浏览器工具都确实存在。
但“存在”不会自动变成“生产级”。
下一层工作更安静,也更重要:有节奏地迁出 create_react_agent,让关键审计与事件真正持久化,把浏览器边界加固到能够面对不可信页面,把 grounding 从数字和命名实体扩展到语义层,并用可复现评测替代漂亮的性能数字。
这次审计留下的哲理不是“少做设计”,而是:
一个设计开始值得信任,是从每一条漂亮箭头都拥有重试策略、责任人和诚实状态开始。
这才是可以继续带向生产的架构。
读者回响