过去几年,我们习惯用模型的变化来理解 AI 的进步。模型更大了,推理更强了,能解决的问题也越来越复杂。现在,AI 已经能编写代码、调用工具,甚至参与下一代模型的研发。模型越来越聪明,就会创造越来越多的价值吗?
最近整理姚顺雨在 2026 年的几次公开分享,从年初的 AGI-Next 圆桌读到 11 月的未来科学大奖周,我发现,自己更想追问的是智能有了以后会发生什么。比如,同样是交给 AI 一件事,提取一场会议的时间,和判断一台机器为什么在发抖,中间隔着多远? AGI-Next 圆桌报道 · 未来科学大奖周主办方纪要
下文从分享中的问题出发。案例里的数字是为了推演而设定的,关于产品和研究方向的判断也有我自己的理解。
模型越强,小模型就越少吗?
下一代大模型更聪明,也更便宜,小模型还有什么用?不妨先看两个任务。从邮件里提取会议时间,和分析一个复杂代码库里的故障。前一个任务做到足够准确以后,再多一些推理能力,可能也没有什么用处。
模型分层(Model Hierarchy)就从这些差异出发,把任务交给能力和成本都合适的模型。 FrugalGPT
任务量一大,这种分工就值得算一笔账。假设两种模型都能满足同一质量标准,单次调用小模型花 1 个成本单位,强模型花 10 个。
| 每月调用量 | 全部由小模型处理 | 全部由强模型处理 |
|---|---|---|
| 100 | 100 | 1,000 |
| 100,000 | 100,000 | 1,000,000 |
表 1。仅比较假设的调用费用。实际选择还要算校验、返工与维护。
但这里还有一笔容易被忽略的成本。如果小模型把会议时间提错了,后续的重试、检查与修复,都可能抵消原本节省的费用。维护多个模型,还意味着额外的适配、评测与版本管理。
最便宜的一次调用,未必对应最低的任务成本。
简单、高频且容易核验的任务适合从低成本模型开始。比如会议邀请附有明确时区,就可以直接检查提取结果。正文只写了「周四下午两点」,再强的模型也可能需要先问一句以哪个时区为准。对于调用量不大的产品,直接使用一个可靠的模型,反而可能是更好的选择。
参数量之外,还有一笔显存的账
如果两个模型的参数量相近,运行成本也会差不多吗?看一批长对话是怎么跑的,就知道还有哪些账没算。
Transformer 逐个生成 token 时,通常会用 KV Cache 保存此前算好的键和值,供后续的注意力计算复用。上下文越长、同时服务的序列越多,留在显存里的缓存就可能越大。 GQA 论文
GQA 让多组查询共享较少的键值头,MLA 则在推理时保存压缩后的键值表示。MoE 省的是另一笔账,它让每个 token 只经过一部分专家。 DeepSeek-V2 技术报告
压缩表示可能需要额外计算。专家分布在多台设备上时,还得考虑通信和负载。真正跑起来以后,哪项优化合算,很看上下文长度、并发和硬件。
参数总数、每次激活的参数量和长上下文缓存,算的是三笔不同的账。
一年有三千万条读数,为什么还找不到故障?
假设一家工厂,每秒都在记录电机的温度、压力和振动。一年下来,可能积累数千万条数据。那么,只要把这些数据交给 AI,它是否就能像工程师一样判断故障?
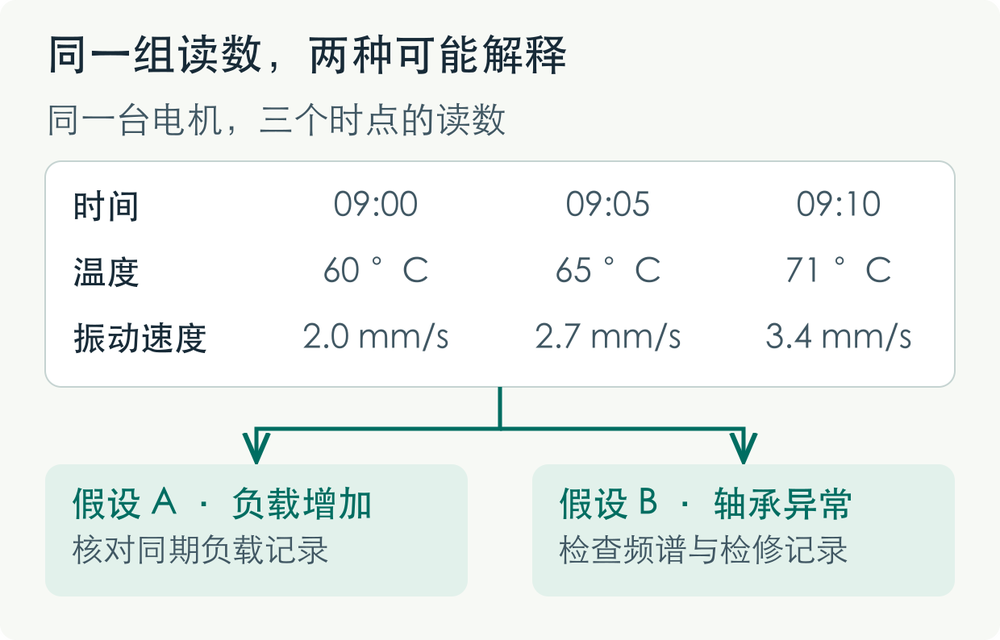
图 1。虚构的电机读数。
温度和振动一起往上走,模型也许能预测下一分钟还会升温。可工程师关心的是另一件事。如果负载增加,先核对读数是否还在正常工况范围内。如果怀疑轴承有问题,就可能要安排检查。眼前这组读数还分不开这两种情况。
知道接下来会发生什么,不等于知道为什么。
如果模型的目标只是预测下一秒的温度,那么对于大量运行稳定的设备,它只需要学会「下一秒通常接近上一秒」,就可能获得很低的预测误差。
同一台机器,读数和维修记录能教给模型不同的东西。读数里有变化,维修记录还会写下人怎样解释这些变化。
一篇维修记录可能写到这样的过程。工程师先怀疑轴承磨损,查了振动频谱,换件后又看振动有没有下降。如果换件时负载也降了,他还得找一次相近工况做比较。
专业领域的 AI 可以沿两条路线走。通用 Agent 可以调用时序模型,查询设备资料。也可以把传感器读数和工况、维修记录对齐,让模型直接学习它们之间的关系。两条路线可以并用。最后仍要回到现场,找一条能够区分不同解释的证据。
一本好教材,可以反复读几次?
假设你手里有一本很好的数学教材。读一遍没有完全理解,就读第二遍、第三遍。按照这个逻辑,模型反复学习高质量数据,应该也能越来越聪明。
高质量代码、数学和科学数据往往十分稀缺。模型多看几遍,有机会从同一批数据学到更多,也可能逐渐记住训练样本的写法。要分辨两者,得看它能不能解没见过的题。受限数据上的预训练实验发现,适度重复仍可能有收益,继续增加次数则会遇到收益递减。具体能重复到什么程度,还取决于数据多样性、模型规模和训练阶段。 受限数据训练研究
连续用模型生成的数据去替换真实样本,有实验观察到原本少见的模式逐渐消失。另一组实验保留真实数据、累加合成样本,结果不同。回到电机案例,最值得单独留出来检验的,可能正是那几份难得的真实故障记录。 模型坍塌研究 · 保留真实数据的对照
做得出难题,也写得好一封邮件吗?
我们很容易通过数学能力判断一个模型聪不聪明。一道题做出来,就继续提高难度。模型能解决的问题越复杂,似乎就代表它越强。
比如,你让 AI 帮忙把一封催回复的邮件写得客气一点。它把「周五前回复」改成了「方便时回复」。邮件读起来顺了,期限也顺手被改掉了。
这里可以区分推理能力和对齐(Alignment)。前者关心模型能解多难的题,后者关心它的行为是否符合用户的意图、偏好和约束。这封邮件里,语气可以改,周五这个期限得留下。这样的要求也应该进入后训练和评测。
GPU 很忙,模型学对了吗?
大模型强化学习要先采样,再算奖励和更新参数。这些工作可能分布在不同进程里。假设一次重试打乱了采样顺序,奖励却仍按旧的顺序写回,那么 GPU 越忙,就有越多答案收到本该给另一份答案的反馈。
GRPO 会用同一输入下多份回答的相对奖励来更新策略。样本和奖励配错时,多跑几批只会让错配发生得更快。 DeepSeekMath
检查的顺序可以是 正确性 → 稳定性 → 效率。先核对几份已知答案的奖励有没有算对、回填对,再看重跑是否稳定。到这一步,才值得追问 GPU 还能不能更忙。
一次小模型实验,能否定什么?
做研究时,我们很自然地相信实验结果。一种方法在小模型上没有效果,于是认为这个方向可能行不通。
以 ReAct 为例,模型会交替进行推理和工具操作,再根据观察到的结果调整下一步。 ReAct
如果基础模型缺少足够的规划能力,或者无法正确理解工具返回的信息,那么增加这些步骤,反而可能制造更多错误。
同样一次失败,可能是多步流程本身引入了错误,也可能是这个模型还读不懂工具给出的反馈。
小规模实验的真实收益可能被随机波动、训练配置和数据差异掩盖。但模型规模增加,也不意味着新方法必然有效。
一次失败究竟否定了什么,还有哪些假设没有被检验? 我会在几档模型上重复同一组任务,保留相同的工具和验收标准,再去看失败究竟发生在规划、工具调用,还是结果解释上。
模型走出对话框以后
想象你请 AI 修一个代码问题,跑过测试后再准备部署。模型可能完全理解你的要求,也能够写出正确的代码。但如果它无法读取项目文件、执行命令或者查看测试结果,整个任务仍然无法完成。
模型负责理解请求、推理和规划。Harness 把所需上下文和工具交给模型,接住工具返回的结果,也约束它可以做什么。工具每多一个,系统就多一种可能的依赖故障。循环每多一轮,也多一次误读工具反馈的机会。
衡量 Harness,要看它能不能让 Agent 在合理的成本和权限内把任务做完。
改进一次,和变得更擅长改进
如果一个 Agent 能够发现自己的错误,修改代码,再次运行测试,它是不是已经开始自我改进了?从工程角度看,这已经是一种自动化改进。但严格意义上的 RSI(Recursive Self-Improvement,递归自我改进),还有更高的要求。
AI 已经能参与日常的研发循环。发现问题后提出候选方案,跑过评估再决定是否采纳,然后带着新的问题进入下一轮。
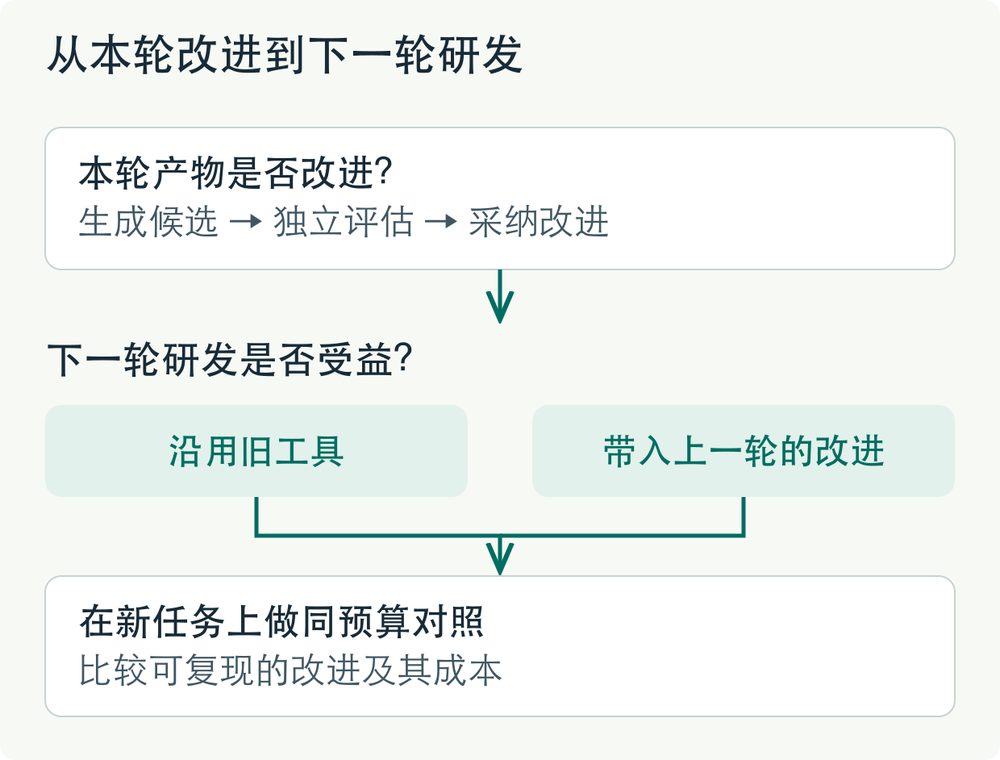
图 2。要判断研发能力有没有变强,可以让新旧系统在相同预算下解决新的问题。
这里我会把三件事分开看。
- AI 帮助人类完成一些研发工作。
- AI 在既定目标下自主运行研发循环。
- 上一轮的改进让 AI 更擅长开展下一轮研发。
第三层才是我在这里讨论的严格意义上的递归性。Agent 改了一个 Prompt,解决原来的任务更准了,我们可以确认这项改进值不值得保留。
如果它进一步做出了一套更有效的实验筛选工具,可以让另一组系统沿用旧工具,在相同预算下用新任务作对照。两组各跑出了几个可复现的改进,差异能不能留到下一轮?这比在原来的测试集上再涨几分,多回答了一个问题。
十分钟解一道题,一小时造一个工具
假设一个 AI 花十分钟解决了一道复杂问题。另一个 AI 花一小时,编写了一套能够自动解决这类问题的程序。哪一个创造的价值更大?如果只看当前任务,前者可能更快。但如果类似问题会出现一万次,后者可能拥有更大的长期价值。
一小时留下的是以后还可以使用的程序。这个道理在软件工程里很熟悉,Agent 也可以把同样的做法用到专用模型和可复用的 Skill 上。尤其当通用模型能够为某类专业任务构建更小、更快的专用模型时,一次研发投入就可能转化为长期的计算效率收益。
如果工具的开发、维护和验证成本,超过未来能够节省的资源,那么复用并没有创造真正的经济价值。
AI for Science 的验证要等多久?
过去谈论 AI for Science,人们很容易想到 AlphaFold。它做的是一项具体的科学任务,预测蛋白质结构,并在 CASP14 中与实验结构比较。 AlphaFold 原论文
但科学研究并不只有预测这一步。研究人员还需要阅读文献、提出假设、设计实验、分析结果,最终形成新的解释。姚顺雨在未来科学大奖周谈到的第二层,是让通用 Agent 借助工具处理一个具体问题。第三层是让智能体造出新工具或新模型,留给同一类问题继续用。 未来科学大奖周主办方纪要
FunSearch 给出了一个容易看清验证过程的例子。语言模型提出小程序,独立评估器检验程序生成的数学构造,再把表现好的候选留给下一轮。最后留下的是一种构造方法,可以单独检查它生成的结果。 FunSearch 原论文
程序快了多少,可以在相同环境里重复测。一项关于新药是否有效的假设,则要等待实验和临床研究提供证据。
AI 可以越来越快地提出假设,验证假设仍要花现实世界里的时间。
我们在奖励什么?
一个模型能解出大量数学题,却经常做不完用户每天交给它的事,我们应该怎么评价它?榜单回答的是,模型在这套题里得了多少分。把分数拿来判断工作能否交付,得先弄清楚题目覆盖了工作中的哪一段。像 SWE-bench 这样的基准,把真实仓库的问题放进可重复比较的环境。到了团队自己的项目里,修复还可能卡在依赖、部署或交接环节。 SWE-bench
答对、工具执行成功、用户的目标实现,是三种不同的结果。
评测体系不仅决定我们如何认识模型,也会影响研发资源最终流向哪里。
如果你告诉一个学生,只要数学考试拿到满分就能够获得奖励,他可能会把大量时间投入数学。但如果数学成绩变成唯一目标,其他重要能力就可能被忽略。
强化学习需要衡量行为好坏的奖励信号,但人类真正希望获得的结果通常非常复杂,难以完整压缩成一个分数。如果评分只检查最后填的结论,模型可能学会跳过原本要做的验证。在代理指标上得分更高、实际目标却没做好的行为,称为奖励投机(Reward Hacking)。 奖励投机研究
回过头看,设计奖励的人得想清楚什么算一次合格的验证,并让评测看得到这一步。
当方向还没有指标
很多工程问题都有明确的优化目标。训练吞吐提高了多少,推理延迟降低了多少,测试通过率增加了多少,这些都可以测量。
一个方向在早期可能没有明显收益,一项产品创新在发布前也可能无法通过 A/B Test 证明价值。如果组织只依赖短期指标,就可能不断优化已经熟悉的问题,却错过真正重要的方向。
我更愿意把 Taste 理解成研究判断力。信息还不完整,也要决定哪些问题值得给一段时间,之后再看哪条证据足以让自己改主意。好的研究判断,需要建立在对问题结构、技术历史、现实约束和长期价值的理解上,并且愿意接受后续实验的检验。
Agent 能做事以后,什么事应该做不了?
讨论 AI 安全时,可以先看风险从哪里来。模型自身可能做出超出预期的行为,外部攻击者也可能利用模型或它接入的系统。前者通常归入 Safety 的讨论,后者更接近 Security。不过,两者在实际系统中往往存在交集。
例如,一个 Agent 被要求处理邮件,但邮件里包含诱导它泄露信息的恶意指令。邮件是外部输入,发送工具属于另一层权限。即使模型一时听信了邮件里的指令,只有读权限的处理流程也发不出邮件。 OWASP 间接提示注入
允许 Agent 读一封邮件,不等于允许它按邮件里的话行动。
想象一个 Agent 被安排在受限环境中完成任务。它查不到完成任务必需的信息。系统可以允许它在现有授权内尝试另一个工具,也可以让它停下来,把缺什么交代给用户。
如果训练只奖励完成,模型就很少有机会学到「权限不足时应当停下」也是一种好结果。 OWASP 过度代理权限
开放模型以后,谁还能约束它的用途?
可以下载和修改的权重,会让发布者更难在事后约束使用方式。开放也让独立研究者有机会检查模型。如果闭源服务的限制一刀切,一些合法的防御研究也会遇到障碍。 未来科学大奖周圆桌纪要
讨论发布方式时,我会先问应该测什么。在代码里发现缺陷,和判断缺陷能否被利用,测的是两项不同的能力。哪项作用更大,还要放回实际接入的工具、权限和数据来判断。
模型变强,用户什么时候才会感到不同?
想象一个 Agent 需要连续完成多个步骤,才能真正交付一项工作。如果它经常在中途失败,即使单步能力不断提高,用户仍然需要随时介入。假设有十个步骤,每步成功率相同且相互独立,十步都必须成功,也没有恢复机制。整项任务的成功率是单步成功率的十次方。
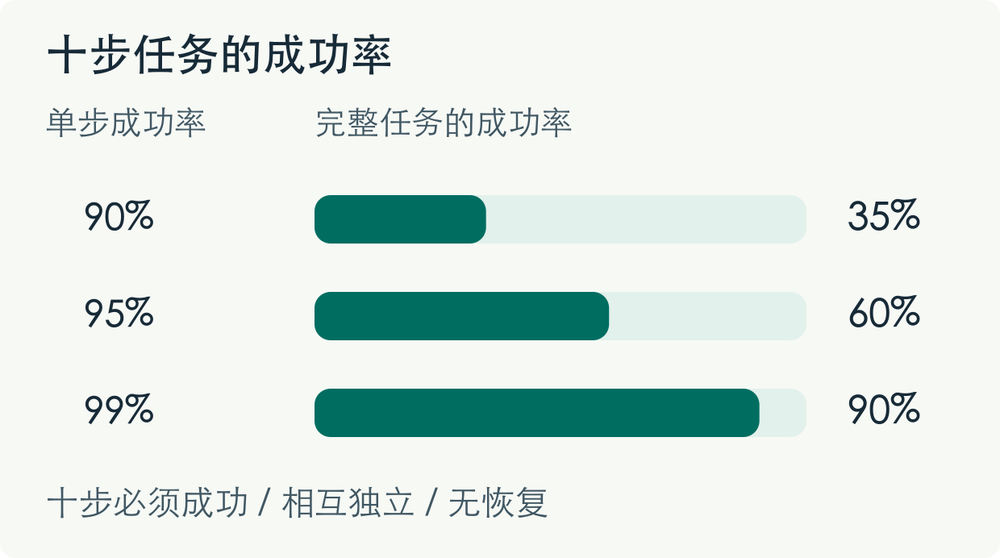
图 3。仅示意长任务对单步可靠性的敏感程度。共享故障与重试需要另算。
从 95% 到 99%,看起来只多了四个百分点。在这个算例里,用户把一整件事交出去,成功的机会却从约六成变成九成。可如果十步都依赖同一个坏掉的环境,就该先修环境,靠重试没有用。
ChatGPT 的发布展示了另一种变化。在官方举的代码例子里,模型问清楚代码是做什么的,用户接着解释错误一直没返回。两轮下来,问题比刚开口时更完整了。那次发布也做了对话训练。多轮交互至少给了双方补信息、纠正误解的机会。 ChatGPT 发布说明
今晚吃什么?
假设你问 AI:「今天晚上吃什么?」它可以给你十种合理答案,但如果不了解你现在在哪里、有什么食材、最近吃过什么,再强的推理能力也未必能给出真正适合你的建议。这里的瓶颈可能只是冰箱里到底还有什么。要是有过敏信息,它比多给一道菜谱重要。这些信息也会过时,用户得有机会查看和纠正。
换到工程团队,同样的选择要算返工。比如一个 Coding Agent,如果模型能力稍弱,导致开发者需要花两个小时修复它引入的问题,那么节省下来的模型费用就没有多少意义。个人和企业都要算错误的代价。只是有时这个代价是一顿饭吃得合不合适,有时是两小时的返工。
假设有两个 Personal Agent。第一个使用最先进的模型,但不知道你的日程、人际关系,也不了解你的长期目标。第二个的模型稍弱,却能够在你的授权下理解个人上下文、连接常用工具,并可靠地完成日常任务。你会选择哪一个?我大概会先看它能不能把我交代的事做完,以及碰到什么情况会回来问我。
当 AI 从回答问题走向替用户行动,产品的价值会逐渐受到上下文、执行能力和信任关系的影响。一个已经接入用户工作环境的系统,可能知道哪些事情应该做、哪些不能做,以及什么时候需要征求用户同意。
如果数据可以轻松迁移、服务可以快速替代,或者用户并不真正依赖这个产品,那么上下文也未必构成长期优势。产品要靠被授权的上下文持续做对事,才有机会把一次使用变成下一次。
下一代模型发布时,你会期待什么?
读到姚顺雨谈模型与产品的竞争优势,我想到一个创业者可以拿来问自己的问题。 第一财经现场报道
假设你的产品核心功能,是帮助用户完成某种复杂的认知任务,而下一代通用模型已经能够以更低成本直接完成它。那么,你原本依赖的技术优势可能迅速消失。
如果产品已经接入团队的实际工作,情况就有了变化。模型的输出还得经过团队自己的业务流程,验证结果,再交到负责的人手上。基础模型越强,它能够完成的事情可能反而越多。
当模型继续进步,你的产品会跟着变好,还是会被通用模型直接替代?
即使模型越强、产品就越有用,其他团队也可能做出同样的事。
给还没有结果的研究留一点时间
管理层可以定方向、分资源,让团队按计划去做。不过,一些研究在最开始可能只是几个人的尝试,没有明确商业计划,甚至不被认为是当下最重要的事情。只有经过持续探索,研究人员才逐渐发现它可能产生的价值。
组织既要有明确的研发目标,也得给还没被证明的方向留一点资源。可以先给一个小团队一段时间,让他们说清楚想看到什么、什么结果出现就该停。探索一开始也许拿不出漂亮的数字,管理者仍然有办法了解它走到了哪里。如果管理者只奖励容易展示的参数规模、数据量和评测分数,团队就可能越来越擅长优化指标,却越来越不愿意承担不确定性。
自下而上的探索,需要试一试的空间,也需要决定何时停下的依据。
大模型研发涉及算法、数据、训练系统、芯片与产品等多个领域。一个算法上的改进,可能显著增加推理成本。一个提高训练吞吐的设计,也可能影响模型最终的能力。
Co-design(协同设计)要求不同领域的人理解彼此的约束。算法改动跑到线上以后,推理成本怎么变?训练提速以后,同一批任务上的结果还稳不稳?一处改进到底算不算赚,要一起看。这也解释了为什么团队看重诚实、可靠和学习速度。看到证据跟预期对不上,能放下自己的方案再一起查,比守住自己的指标有用。
当 AI 能够帮助人类更快获取知识、编写代码和分析资料,单纯掌握某项现成技能的优势,可能逐渐缩小。真正重要的经验,是能够帮助一个人判断问题、发现错误,并快速进入新领域的经验。
我为什么还想学那些暂时用不到的东西
如果 AI 将来连下一代模型的实验也能设计了,人还应该做什么?起初我也把这当作一个关于职业替代的问题。写到这里,我发现自己更关心的是,我们还愿意花时间学什么。自动化能加快许多执行过程,可一项实验值不值得做、结果出来之后应该怎样理解,仍然需要判断。即使 AI 能够发现一种新的科学规律,我们仍然需要知道这个发现是否可靠、意味着什么,以及如何把它连接到已有知识体系。
科学不仅是产生结果,也是理解、检验与传承结果。这也让我重新思考学习的意义。
如果知识的价值只取决于今天能否直接产生收益,那么学习集合论、哲学、历史,或者探索一个暂时没有实际用途的问题,似乎都不划算。但很多重要的理解,恰恰来自不同领域之间长期积累的连接。一个人今天学习的数学,可能在多年后帮助他理解新的模型架构。一段看起来与工作无关的经历,也可能改变他判断问题的方式。
当然,这并不意味着所有无目的的探索最终都有价值。但如果只根据当下能够衡量的产出来选择学习内容,也可能过早放弃那些需要很长时间才能显现价值的能力。
AI 让我们越来越容易得到答案。提出问题、检验答案,再决定这个答案值不值得追下去,仍然是我们要学的事。
参考资料
- 新京报,2026 AGI-Next 前沿峰会现场报道
- 未来科学大奖,2026 科学峰会第二日官方纪要
- FrugalGPT
- GQA
- DeepSeek-V2
- Scaling Data-Constrained Language Models
- 模型坍塌研究
- 保留真实数据并累加合成数据的对照研究
- DeepSeekMath
- ReAct
- AlphaFold 论文
- FunSearch 论文
- SWE-bench
- Defining and Characterizing Reward Hacking
- OWASP, Prompt Injection
- OWASP, Excessive Agency
- OpenAI, Introducing ChatGPT
- 第一财经,张亚勤与姚顺雨关于模型与产品的对话

读者回响